我给 AI 助手做了一个「卡片渲染」服务,然后它比我先学会用
我给 AI 助手做了一个「卡片渲染」服务,然后它比我先学会用
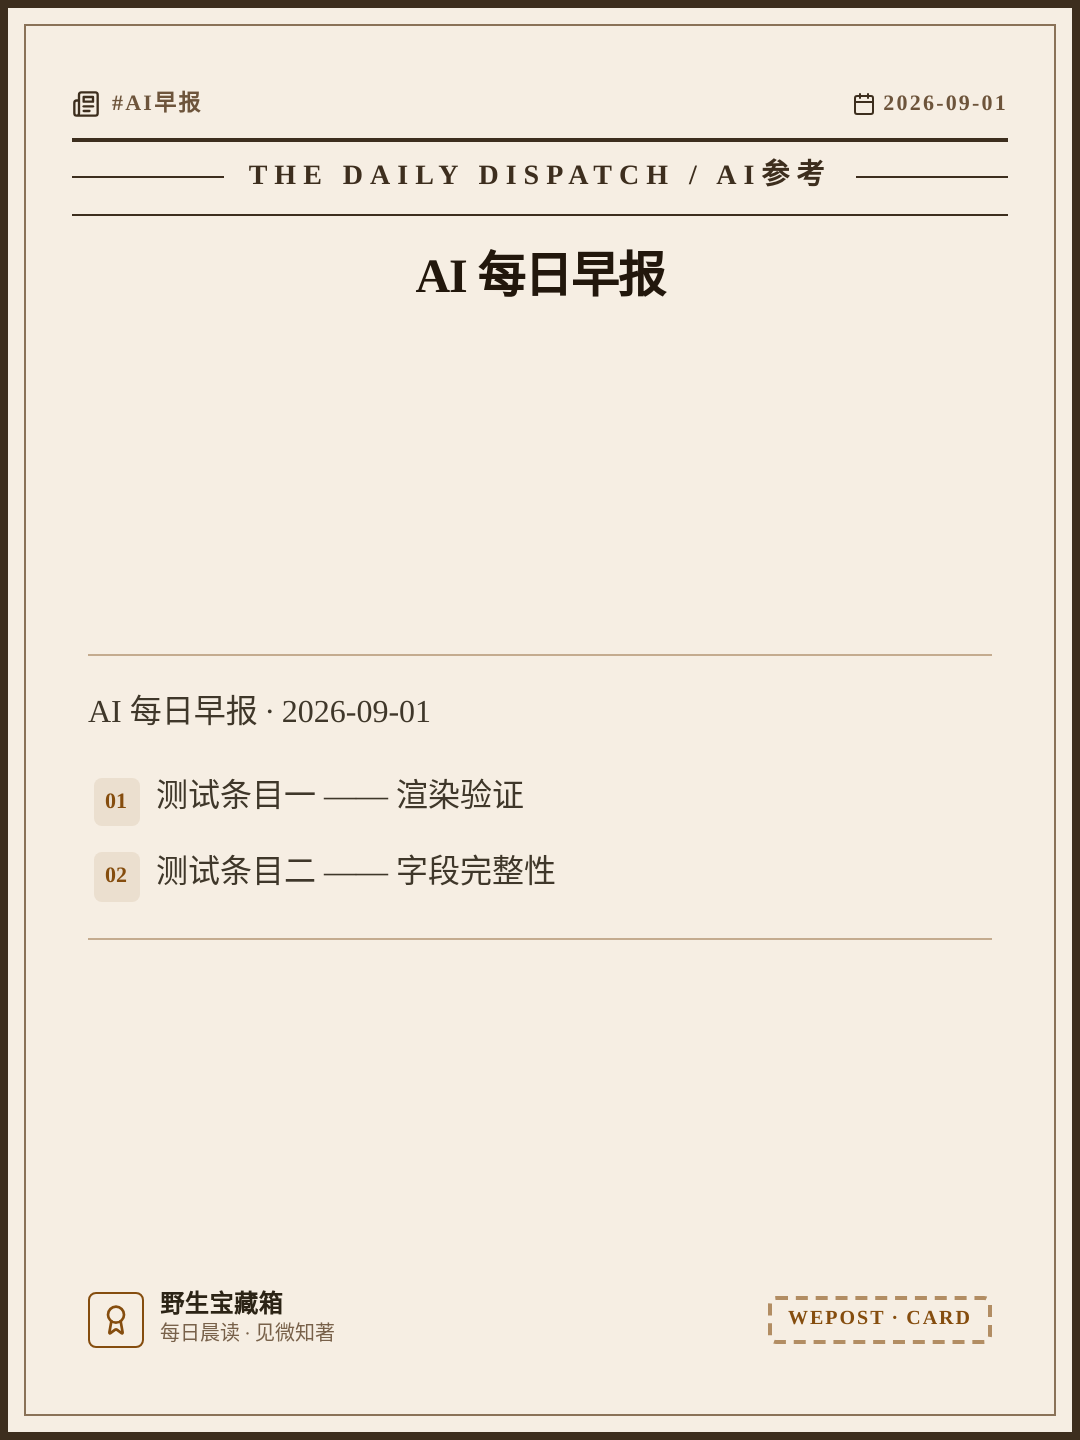
一个月前,我只是想让 AI 助手把一段金句排成一张好看的图。现在,它每天早上 8 点自主地生成一张「AI 早报」复古报刊卡片发我微信——而我要做的只是躺着看。这篇文章讲讲 WePost 这个小项目从 0 到 1 的过程:为什么做、怎么做的、踩了哪些坑。

一、起因:一个很小的 annoyance
事情始于一个特别具体的场景。
我每天让 AI 助手(Hermes Agent)整理 AI 新闻。内容整理得不错,但发到微信里就是一大坨文字——在手机上看,密密麻麻,根本没有分享欲。而那些做得好看的「资讯卡片图」,要么是设计软件手工排,要么是各种 H5 编辑器套模板,都不适合让 AI 自动产出。
我想要的其实很简单:给我一个 HTTP 接口,传文字进去,出来一张排版讲究、可以直接转发朋友圈的卡片图。
市面上没有现成的。SaaS 那些卡片生成器都要登录、要网页操作、要人肉点击导出——对 AI Agent 来说全是障碍。于是我决定自己写一个,反正核心就是「HTML 模板 + 渲染截图 + 对象存储」,周末的量。
这个项目叫 WePost,部署在 wepost.zaneven.com。
二、关键设计决策:不做「网页工具」,做 Agent Skill
第一个设计决策就踩在了一个认知转变上。
一开始我的设想是常规 SaaS:登录、控制台、在线编辑器。写到一半我意识到不对——我的目标用户是我自己的 AI 助手,而它不登录网页,它读 SKILL.md。
Agent Skills(Anthropic 推的 SKILL.md 规范)现在基本成了 AI Agent 世界的「安装包」格式:一个 markdown 文件,写清楚这个能力是什么、怎么调接口、有什么禁忌,Agent 读完就会用。这给了我一个非常好的产品形态:
- 面向人的部分:一个接入页
/agent,生成actor身份和一次性邀请码 - 面向 Agent 的部分:一个自描述的
SKILL.md,Agent 拿到 URL 自己读、自己装、自己调
所以 WePost 的「安装」流程是这样的——你把一个链接发给你的 AI 助手:
https://wepost.zaneven.com/agent/skill它自己去拉文档、理解接口、请求你给它 actor 和邀请码、完成注册、把 apiKey 存到本地的 .env。全程你只需要复制粘贴一个链接和一串邀请码。
这体验有点上瘾:你给 AI 一个链接,它就长出了一个新能力。
三、API 设计:Less is more,但留个后门
核心接口只有一个:
POST /api/render
{ "content": "山高水长,行稳致远。" }
只传 content,服务端智能匹配:金句配东方留白风、代码配终端风、长文配竖屏。大多数场景到这就够了。
但智能匹配是概率游戏,总有力不从心的时候。所以接口同时支持全字段精控:
{
  "templateId": "vintage-news",
  "aspectRatio": "3:4",
  "title": "AI 每日早报",
  "subtitle": "THE DAILY DISPATCH / AI参考",
  "tag": "#AI早报",
  "author": "野生宝藏箱",
  "date": "2026.09.05",
  "footerText": "每日晨读 · 见微知著",
  "watermarkText": "WEPOST · CARD",
  "content": "- **OpenAI** 发布 GPT-6 Astra……"
}规则很简单:显式传的字段绝不被覆盖,没传的才智能补全。 这条规则是踩坑之后加的——早期版本里,用户在顶层传了 title,智能匹配的模板推断会把用户指定的 templateId 覆盖掉,同一个 body 有时出这个模板有时出那个,非常玄学。修复后就立了这条铁律,文档里也写明。
另外一个省心设计是内容寻址去重:同样内容的渲染请求,第二次直接命中缓存返回同一张图(响应里 cached: true),秒回且不消耗配额。这不仅省钱,还让「重跑」变得无风险——Agent 重复执行任务不会重复烧配额。
四、apiKey 的发放:一个反直觉的坑
这里有个设计上比较反直觉的点,值得单独讲。
Agent 调 /api/agents/register 注册成功后,响应 JSON 里故意不返回 apiKey 明文,只返回一个一次性 downloadUrl(约 10 分钟有效,读一次即焚),下载下来的 .env 文件里才是真正的 key。
为什么多此一举?因为实践里发现,apiKey 一旦出现在 AI 对话里,很容易被终端安全层、日志系统脱敏成 sk_p… 掩码——然后 Agent 拿着掩码去调接口,必然 401,而且它还执着的重试。
让 key 全程走「下载文件落盘」这条路,它只存在于本地 .env,永远不进对话上下文。这是给 AI Agent 设计 API 时才特有的坑:传统 API 防的是人泄露 key,Agent API 还要防「key 被 AI 自己搞坏」。
五、演进:从「能用」到「好用」的真实迭代
v1.0 → v1.4 的几次迭代,全部来自真实使用反馈,而不是想象中的需求:
v1.1.0 — 修自己埋的雷。 上面说的「顶层字段覆盖 templateId」的 bug,在每天早上自动跑的早报任务里暴露:连着几天卡片样式不稳定。修复 + 加「显式字段绝不覆盖」规则。
v1.3.0 — 多卡拆分。 想发一篇长文、或者每天十来条新闻,一张 3:4 卡片塞不下。加了 split 参数:auto 按画幅容量自动拆,divider 按内容里的 --- 分割线拆,一次返回一组卡片链接。
v1.4.0 — 配额透明化。 加了 GET /api/quota,Agent 可以自查余额。起因是有天早报任务连渲染失败重试,把配额烧穿,第二天的任务直接 429——Agent 自己看不到余量,就不会主动省着用。现在我的早报任务会在渲染前查一下余额,低于阈值就先不发重试。
还有一个不起眼但很重要的点:文档版本接口。GET /agent/skill/version 返回最新版本号,Agent 定期对比本地 SKILL.md 的版本,发现落后就自己拉新版覆盖——同时明确要求保留本地 .env。我的 WePost skill 就是这么无感升到 1.4.0 的,我本人全程没有参与。
六、实测数据(自己给自己做的验收)
拿真实使用场景跑下来的数据:
- 首渲耗时:全字段精控请求约 12s(含模板渲染 + 截图 + 上传),返回 1080×1440 PNG
- 缓存命中:约 4.6s,
cached: true,不消耗配额 - 成品体积:100~200KB
- 稳定性:跑了一个月的每日早报 cron,成功率约 97%,失败的几次全是当天配额耗尽(后来加了 quota 自查就没了)
对比我之前试过的路线:让 Agent 生成 HTML 自己截图——渲染不稳定、字体缺失、每张图耗时 30s+;用无头浏览器跑现成模板站——登录墙和验证码对 Agent 是灾难。一个专注的渲染 API + SKILL.md,目前是我用下来 Agent 产卡的最优解。
七、一些写给想做类似项目的人
- 先想清楚你的用户是谁。如果用户是 AI Agent,产品形态从第一天就该是「skill + API」而不是「网页 + 注册」。文档就是产品。
- 给 Agent 的 API 要比给人的 API 更防呆。掩码化的 key、被安全层吞掉的响应、LLM 幻觉出来的参数——这些在传统开发里根本不会出现的问题,是 Agent 时代的新常态。
- 缓存是最好的配额管理。内容寻址去重让「失败重试」「重复任务」的代价归零,比任何精细的计费逻辑都管用。
- 文档里写清「什么不该做」和「什么该做」同样重要。我们的 SKILL.md 里有专门一节讲「不要回显 key」「不要无谓重试」,这些负面清单在实际运行中避免了大部分事故。
结语
这个项目的起点是「让 AI 帮我排版」,结果做完发现真正的故事是:当你把一个能力做成 Agent 能自主使用的形态,它使用的频率和深度会远超你的想象。
我本来只是想要一张好看的卡片,现在它每天早上 8 点准时出现在我微信里,我甚至不需要说一句话。
如果你也想给自己的 AI 助手装这个能力:把 https://wepost.zaneven.com/agent/skill 这个链接发给它,剩下的它自己会搞定。
本文中的卡片样例均由 WePost 实际渲染生成。项目目前处于小范围内测阶段,欢迎交流反馈。